 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
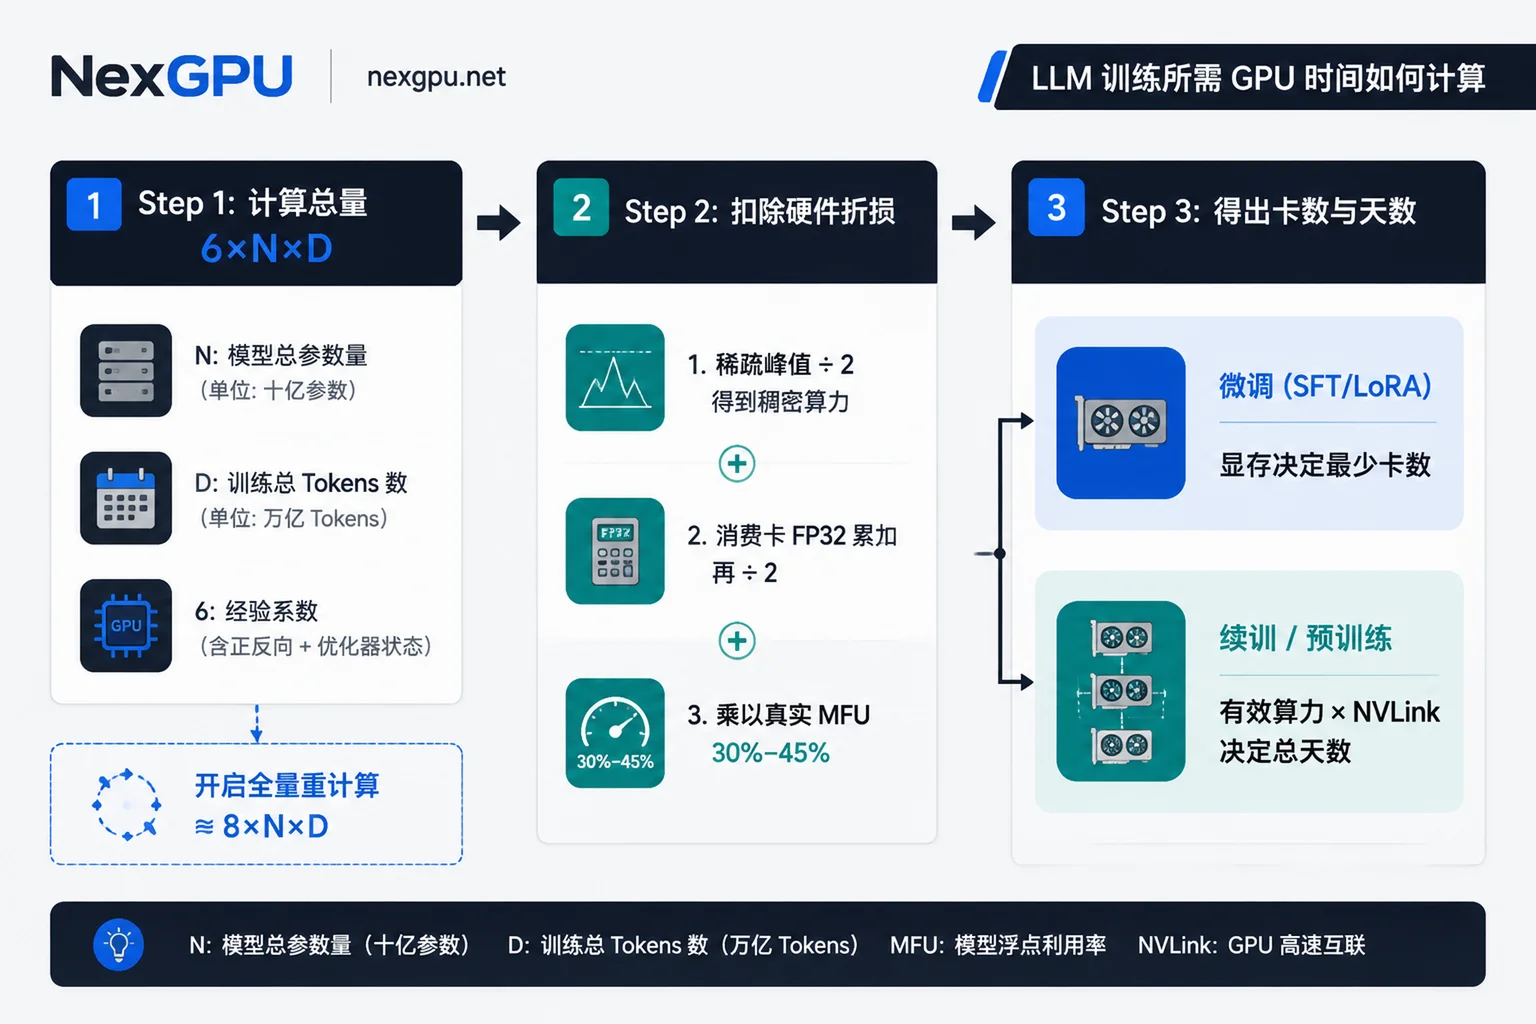
先给结论:估算一次大模型训练需要多少张 GPU、跑几天,不要只看显存大小和宣传页上的峰值算力,而要套用核心算力公式:
- 总计算量(FLOPs)
≈ 6 × N(模型参数量)× D(训练 Token 数) - 所需总 GPU 小时
= (6 × N × D) ÷ (单卡稠密 BF16 算力 × MFU × 3600) - 实际训练天数
= 总 GPU 小时 ÷ (并行卡数 × 24)
按经验口径区分:监督微调(SFT / LoRA)因为训练 Token 量较小(通常千万到十亿级),总计算量往往只需要几到几十个 GPU 小时,此时显存容量决定最少要几张卡;而继续预训练(CPT)与从头预训练动辄百亿到万亿 Token,单卡在 FP32 累加模式下的真实稠密算力、实际有效算力利用率(MFU,通常仅 30%–45%)以及卡间互联(NVLink 与 RDMA)才是决定跑 4 天还是 2 个月的核心变量。
下面拆解三个最容易把训练排期算错的硬件折损坑,再用真实案例演示怎么算出误差最小的租卡方案。
一、为什么按显卡宣传算力估算总会翻车?三个真实折损项
很多团队用显卡官网白皮书上的最高 TFLOPS 除以 6×N×D,算出只需要 2 天,结果上机一跑要 1 周多。问题通常出在以下三层算力折损没有扣除:
1. 稀疏峰值(2:4 Sparsity)必须先除以 2
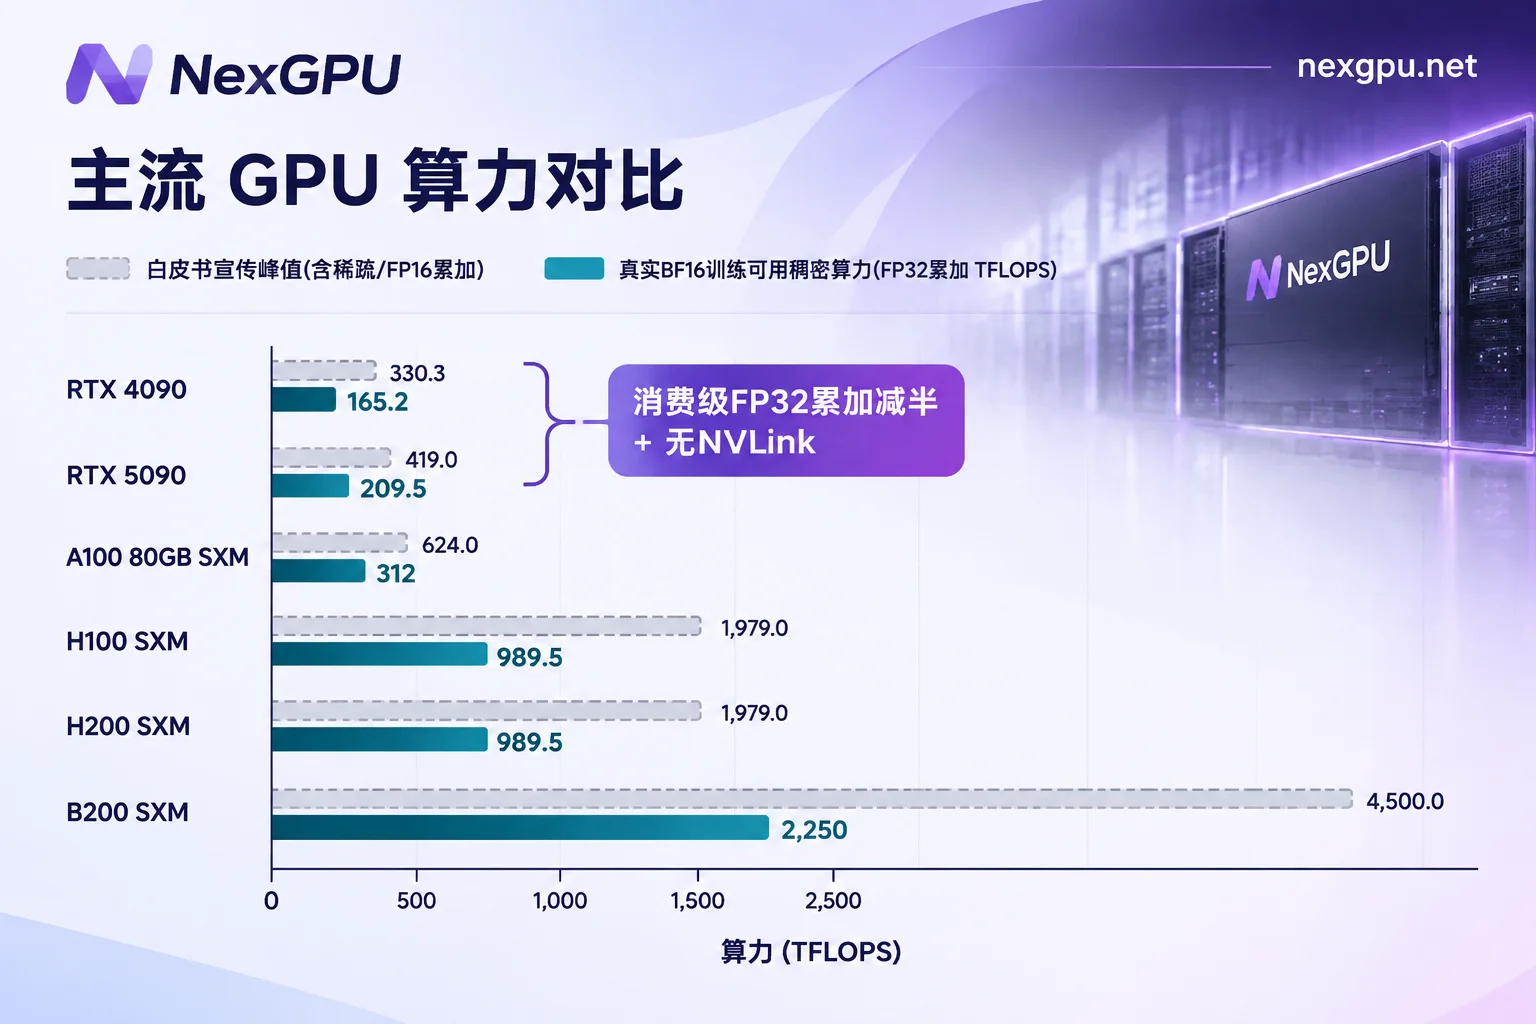
NVIDIA 从 Hopper 到 Blackwell 架构的数据中心宣传表,默认把 2:4 结构化稀疏 算进最高 TFLOPS。但绝大多数大模型训练采用稠密矩阵计算,并不启用结构化稀疏剪枝,因此计算训练吞吐时必须先将标称稀疏峰值减半:例如 H100 SXM 在 BF16 下的稠密算力是 989.5 TFLOPS(而非宣传页常见的 1,979),B200 在 BF16 下的稠密算力是 2,250 TFLOPS(而非 4,500)。
2. 消费级显卡在训练模式下 Tensor Core 实际减半
这是在挑选 RTX 4090、RTX 5090 跑模型训练时最隐蔽的坑。为了保证梯度更新不溢出,主流 BF16/FP16 混合精度训练默认使用 FP32 累加器(FP32 Accumulate)。NVIDIA 对消费级 GeForce 显卡在固件与硬件层面将 FP32 累加模式的 Tensor Core 吞吐限制为 FP16 累加模式的 50%:
- RTX 4090:FP16 累加稠密算力约 330 TFLOPS,但真实训练常用的 BF16(FP32 累加)只有 165.2 TFLOPS。
- RTX 5090:FP16 累加稠密算力为 419 TFLOPS,而在 BF16(FP32 累加)训练路径下实测与规格口径均只有 209.5 TFLOPS。
- A100 / H100 / H200 / B200 等数据中心卡:不受此限制,FP32 累加均以全速运行。
也就是说,单看白皮书数字你可能以为 RTX 5090 比 A100(312 TFLOPS)还快,但一旦进到真实的 BF16 训练循环,A100 单卡纯算力反而比 RTX 5090 高出近 50%,更别提消费级卡没有 NVLink 带来的多卡同步差距。
3. MFU 只有 30%–45%,且 nvidia-smi 利用率不等于 MFU
MFU(Model FLOPs Utilization,模型算力利用率) 指模型实际每秒完成的 6ND 有效计算量占硬件理论峰值的比例。在大规模数据中心集群上,经过良好调优的训练任务 MFU 通常在 35%–45%;初次搭建的新框架或跨机通信未调优时往往只有 20%–30%。如果租用的是无 NVLink、纯靠 PCIe 传输梯度的多卡消费级节点,数据并行与 FSDP 通信开销会进一步拖低有效利用率。
还要注意两个常见误解:
nvidia-smi显示 GPU 利用率 95%,不代表 MFU 有 95%:它只说明 GPU 没完全闲着,包括等待显存读写、等待梯度同步的时间都算在“忙碌”里,真实算力利用率可能不到 35%。- 开启激活重计算(Gradient Checkpointing)会变相拉低计算效率:为了省显存而全量重算前向激活,会让硬件实际执行的计算量从
6×N×D涨到约8×N×D,相当于耗时直接多出三分之一。
二、2026 主流大模型训练GPU真实算力与定位对比
下表统一按 训练实际可用的稠密 BF16(FP32 累加)口径 整理,帮你直接横向对比算力与互联能力:
| GPU 型号 | 显存与带宽 | 稠密 BF16 (FP32累加) | 稠密 FP8 | 卡间互联 | 更适合的训练阶段 |
|---|---|---|---|---|---|
| RTX 4090 | 24GB GDDR6X 1.01 TB/s | 165.2 TFLOPS | 330 TFLOPS (无原生培训生态优) | 无 NVLink (PCIe 4.0) | 7B–14B 模型 LoRA/QLoRA 微调、小规模实验 |
| RTX 5090 | 32GB GDDR7 1.79 TB/s | 209.5 TFLOPS | 838 TFLOPS (支持 FP4/FP8) | 无 NVLink (PCIe 5.0) | ≤14B 模型 SFT、≤32B QLoRA 微调、单卡快速验证 |
| A100 80GB SXM | 80GB HBM2e 2.04 TB/s | 312 TFLOPS | 不支持 | NVLink 3.0 (600 GB/s) | 中小团队 BF16 全参微调、70B 级 LoRA、预算可控的 CPT |
| H100 SXM | 80GB HBM3 3.35 TB/s | 989.5 TFLOPS | 1,979 TFLOPS | NVLink 4.0 (900 GB/s) | 2026 主力训练卡,7B–70B+ 预训练、CPT、FP8 混合精度训练 |
| H200 SXM | 141GB HBM3e 4.80 TB/s | 989.5 TFLOPS | 1,979 TFLOPS | NVLink 4.0 (900 GB/s) | 超长上下文训练、大参数模型减少张量并行切分与通信税 |
| B200 SXM | 180GB HBM3e ~8.00 TB/s | 2,250 TFLOPS | 4,500 TFLOPS | NVLink 5.0 (1,800 GB/s) | 大规模预训练与高吞吐后训练,单卡可直接装下更大参数规模 |
选型时需要注意两项软件栈约束:一是 A100 硬件不支持原生 FP8,使用 Transformer Engine FP8 加速训练至少需要 Hopper(H100/H200)或 Blackwell(B200);二是 Blackwell 架构(如 RTX 5090 sm_120、B200 sm_100)需要较新的驱动与 CUDA 环境(RTX 5090 需 CUDA 12.8+),不要直接套用旧版 PyTorch 镜像。
三、三类真实训练任务:算力账与卡数该怎么定?
下面用三组最常见的训练量级,按公式把不同显卡的耗时直接算出来,方便你做项目排期。
场景 1:继续预训练(CPT)—— 8B Dense 模型续训 50B Tokens 行业语料
很多行业大模型项目会基于开源 8B 底座注入数百亿 Token 的专业文档。此时总计算量为:6 × (8 × 10⁹) × (50 × 10⁹) = 2.4 × 10²¹ FLOPs
假设你整租一台 8 卡节点,对比不同卡型的预计跑完时间:
- 8× B200(BF16,按 40% MFU):单卡有效算力
900 TFLOPS,总需求约741 GPU 小时,8 卡并行只需 约 3.9 天(若开启成熟 FP8 训练可进一步压缩至 2 天左右)。 - 8× H100 SXM(BF16,按 40% MFU):单卡有效算力
395.8 TFLOPS,总需求约1,684 GPU 小时,8 卡并行需要 约 8.8 天;若通过 Transformer Engine 启用 FP8 训练,可缩减到 约 4.4 天。 - 8× A100 80GB SXM(BF16,按 40% MFU):单卡有效算力
124.8 TFLOPS,总需求约5,342 GPU 小时,8 卡并行需要 约 27.8 天。 - 8× RTX 5090(PCIe 多卡,BF16 FP32 累加):受限于 FP32 累加半速(209.5 TFLOPS)及无 NVLink 导致的跨卡梯度同步损耗(MFU 按较乐观的 28% 计,单卡有效约
58.7 TFLOPS),总需求约11,357 GPU 小时,8 卡跑完需要 近 59 天。
可以看到,在百亿 Token 以上的续训任务里,消费级多卡看似单小时租金低,但拉长到近两个月的运行周期后,不仅总算力账单未必占优,还把研发迭代节奏拖慢了 6 倍以上。此时上 8 卡 H100 或 B200 才是最省时间与总成本的做法。
场景 2:从头预训练 —— 7B Dense 模型跑 1T Tokens,或 MoE 架构怎么算?
- Dense 模型:7B 参数跑 1T(
10¹²)Tokens,总计算量6 × 7×10⁹ × 10¹² = 4.2 × 10²² FLOPs。在 40% MFU 的 H100(BF16)上约消耗 29,480 GPU 小时。如果租 8 张 H100 要跑 153 天显然不现实,而扩展到 64 卡或 128 卡 RDMA 集群(8–16 台 8 卡节点),则能在 10–20 天内交付。 - MoE(混合专家)模型:公式中的参数量
N要替换为每个 Token 实际激活的参数量N_active,而不是总参数量。比如总参数 30B、每次激活 3B 的 MoE 模型,训练计算量接近 3B Dense 模型;但显存仍然要装下全部 30B 权重及对应的优化器状态,选卡时不能按 3B 去配显存(多卡显存拆账与互联规则可进一步参考大模型训练GPU选型:先算显存账,再定互联和卡数)。
场景 3:SFT 与 LoRA/QLoRA 微调 —— 32B 模型训练 100M Tokens
微调的数据量通常只有千万到数亿 Token。以 32B 模型在 100M(10⁸)Tokens 上做全参数微调为例:6 × (32 × 10⁹) × (1 × 10⁸) = 1.92 × 10¹⁹ FLOPs
在 8× H100 SXM(BF16,40% MFU)上,纯计算只需 约 13.5 个 GPU 小时,8 卡并行 不到 2 小时 就能完成训练(加上数据加载与评估约 2–3 小时)。
这里为什么不能只租 1 张 H100 跑 14 小时?因为 32B 全参微调在 BF16 混合精度(含 AdamW 优化器状态与梯度)下需要约 512GB 显存(尚未计入长序列激活值),单卡装不下,必须用 8×80GB 节点把显存池凑齐;如果你改用 QLoRA 或仅对少数层微调,则 1 张 H200/A100 80GB 或双卡 RTX 5090 就能放下,算力花费极低(具体微调框架与 RL 后训练配卡可对照2026大模型训练GPU怎么选:从SFT到GRPO强化学习后训练的显存账与多卡成本实操及2026大模型微调GPU与框架选型实战)。
四、比公式更准的租卡流程:2 小时实测吞吐再放量
官方公式适合在立项阶段判断量级(误差通常在 30%–50%),因为序列长度、DataLoader IO、MoE 路由负载以及通信重叠率都会改变真实 MFU。最稳妥的工程做法是先做一次 1–2 小时的实测摸底(Pilot Run),直接测出你真实代码的 tokens/s/GPU(单卡每秒处理的训练 Token 数):
- 租单台目标机型跑 200–500 个 Step:固定你的真实序列长度、Batch Size 与框架配置(DeepSpeed / FSDP / Megatron)。
- 用实测速度反推总耗时:跳过 MFU 猜测,直接套用公式:
总 GPU 小时 = 训练总 Token 数 ÷ (单卡实测 tok/s × 3600),再叠加 15%–20% 的评估与 Checkpoint 保存余量。 - 确认扩展效率后放量开卡:如果 8 卡跑完还要跨机扩到 32/64 卡,务必先验证跨节点 RDMA 带宽是否掉速,再锁定大集群预算。
如果你需要灵活完成从“单机摸底”到“多卡放量”的过渡,可以直接在 大模型训练GPU 算力市场按需挑选节点。NexGPU 把全球分布式消费级显卡(RTX 3090/4090/5090)与数据中心级节点(A100/H100/H200/B200)集中在一张透明列表里,有几处设计尤其贴合训练算账与测试需求:
- 先测后买,零启动门槛:按秒计量算力、按小时计价,没有起租时长和最低消费,下单时即锁定单卡小时单价且整机金额等于
单卡价 × 卡数;邮箱注册即可查看实时节点价格,无需实名认证与漫长配额审批。 - 显存与多卡筛选一步到位:可按显存容量、最少卡数、地区与带宽筛选机器;先选好框架环境时,系统会自动标出显存不足的节点并说明原因,避免开机即 OOM。
- 镜像模板与自定义 CUDA 自由度:训练分类直接预置了 PyTorch、JAX、TensorFlow 及 LLaMA Factory、Axolotl、Unsloth 等模板;当代码使用了 RTX 5090 或 B200 并锁定特定 CUDA 版本(如 CUDA 12.8+)时,也支持填写公开或私有 Docker 镜像并自定义启动命令。
- 多节点与企业级互联:中小规模训练可在市场直接筛选 8 卡 A100/H100/H200 节点自助下单(支持 DeepSpeed、FSDP、Megatron);如果要做大规模多机预训练或需要 RDMA 高速互联、专属算力池、包月预留与对公付款开票,可通过企业方案通道定制集群拓扑。
两项长任务账单与数据提醒:NexGPU 在实例停机期间算力计费立即停止,但存储费(按 GB/月计)仍会继续收取;此外平台不提供自动数据备份,实例一旦销毁磁盘将立即释放且无法恢复。建议长周期训练务必按照云端GPU长任务中断恢复与Checkpoint设置配置自动断点保存,并在训练阶段结束或销毁实例前将权重同步到外部对象存储。
五、立即可用的 30 秒选卡决策清单
下单租卡前,按下面四步核对一遍即可避免 90% 的错配:
- 确认任务类型:Token 量
< 1B的 SFT/LoRA,按「显存能装下权重+激活」选最便宜的卡(RTX 4090/5090 或单张 A100/H200);Token 量≥ 10B的 CPT 或预训练,直接按6×N×D算力账上 Hopper/Blackwell 数据中心卡。 - 对齐稠密真实算力:剔除白皮书 2:4 稀疏倍增,消费级卡按 FP32 累加半速口径计算,MFU 先按保守的
35%排期。 - 检查硬件互联与 CUDA 栈:多卡高频同步避免走无 NVLink 的多卡 PCIe 节点;Blackwell 显卡(RTX 5090/B200)提前确认镜像内的 CUDA 与 PyTorch 算子版本匹配。
- 2 小时实测验证:租 1 台目标节点跑通 500 步记录真实
tokens/s/GPU,算清最终费用后再决定是按小时全速跑完,还是转企业包月集群。


